Error Budgets: Die Finanzabteilung für Reliability

Nico Braun
Juli 15, 2026
⏳ 12 min
Stell dir vor, du führst einen Haushalt. Du hast ein monatliches Budget für „Spaß-Ausgaben". Essen gehen, Konzerte, vielleicht auch dieses eine LEGO-Set, das dich schon länger anlacht, aber einen Ticken zu teuer ist. Eines ist klar: Wenn du schon in der ersten Woche alles auf den Kopf haust, wird der Rest deines Monats ziemlich karg und unentspannt.
IT-Systeme so zu behandeln, als müssten sie 100% Uptime haben, ist in etwa so, als würdest du versuchen, ein Leben zu führen, in dem du nie, wirklich nie, auch nur einen Cent für etwas Unnötiges ausgibst. Klingt nobel, ist aber in Wahrheit das perfekte Rezept für Burnout und eine extrem langweilige Existenz.
Reliability komplett zu ignorieren macht aber genauso wenig Sinn wie sein gesamtes Gehalt schon am dritten Tag zu verprassen. Im ersten Moment fühlt sich das vielleicht nach Freiheit an. Der unvermeidliche Absturz wird allerdings brutal.
In der Welt des Site Reliability Engineering (SRE) gibt es für dieses Spannungsfeld ein deutlich besseres Werkzeug: das Error Budget.
"The Fun Fund" jar filled with coins labeled "Safe Failures" and "Calculated Risk"
Einfach erklärt beschreibt das Error Budget den Grad an Unzuverlässigkeit, den ein Service tolerieren darf, bevor sich die Prioritäten im Engineering ändern müssen. Gleichzeitig verbindet es technische Kennzahlen wie SLOs und SLIs mit geschäftlichen Entscheidungen rund um Release-Geschwindigkeit, Risiko und Governance.
Die Metrics Hierarchie
Bevor wir über Budgets sprechen können, muss klar sein, was wir überhaupt messen. Bei shiftavenue erleben wir häufig, dass Teams ihr Monitoring mit Reliability verwechseln. Dabei macht es einen großen Unterschied, ob auf einem Dashboard ein Ausschlag zu sehen ist oder das Business tatsächlich darunter leidet.
Genau hier kommt die SRE Metrics Hierarchy ins Spiel.
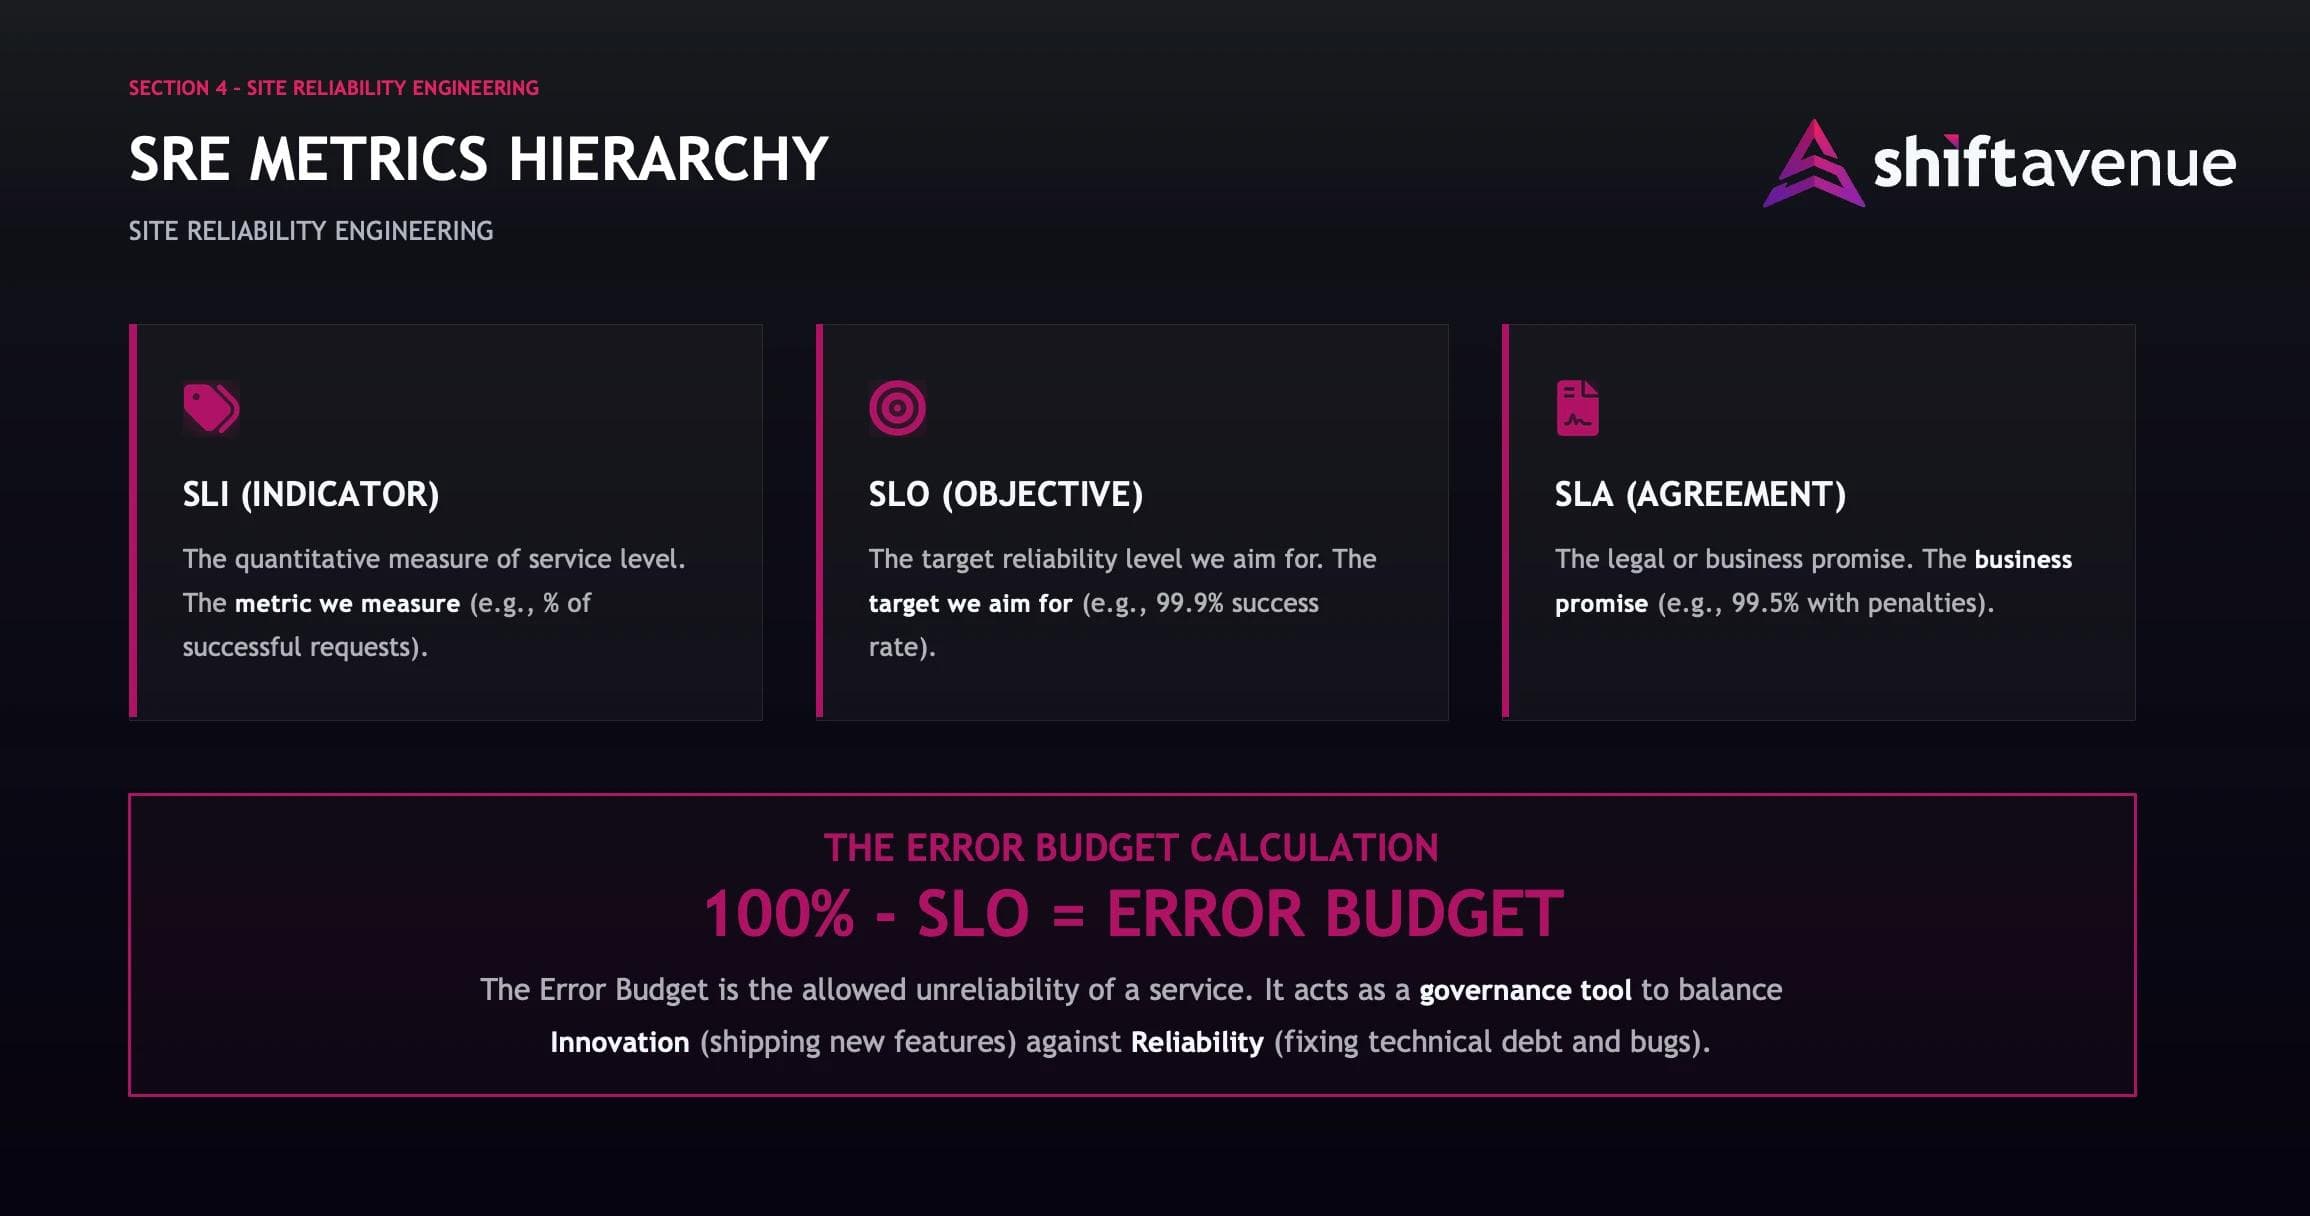
Infographic explaining the SRE Metrics Hierarchy
Wie im Diagramm oben zu sehen, lässt sich das in drei Ebenen unterteilen:
1. SLI (Service Level Indicator)
Zeigt was wir tatsächlich messen können, etwa den Prozentsatz erfolgreicher Requests oder die Latenz des Checkout-Services.
2. SLO (Service Level Objective)
Der Zielwert, den wir erreichen wollen. Technische Anforderungen werden hier in konkrete Zielen übersetzt. Für den SLI „erfolgreiche Requests", wäre „99,9 % erfolgreiche Requests innerhalb von 30 Tagen" ein möglicher SLO.
3. SLA (Service Level Agreement)
Geschäftlicher Nutzen, den wir unseren Kunden zusichern. Wird dieses Versprechen gebrochen, gibt es Konsequenzen - meist finanzieller oder rechtlicher Natur.
Die magische Formel ist simpel:
100% - SLO = Error Budget
Liegt dein SLO beispielsweise bei 99,9 %, bleiben dir 0,1 % Error Budget. Diese 0,1 % sind weit mehr als nur ein Puffer für den Fall, dass etwas schiefläuft. Sie sind deine License to Innovate.
Was ist eigentlich ein Error?
Zu sagen „Wir tracken Errors" ist einfach. Deutlich schwieriger ist die Frage, was in einer produktiven Umgebung überhaupt als Error zählt.
Eine Anfrage kann technisch gesehen erfolgreich verarbeitet worden sein. Wenn die Antwort aber erst nach zehn Sekunden kommt, hat dein Kunde den Warenkorb wahrscheinlich längst verlassen. Genau deshalb hat Google die Four Golden Signals definiert:
1. Latency: Die Zeit, die benötigt wird, um einen Request zu verarbeiten. Erfolgreiche und fehlgeschlagene Requests sollten hier getrennt betrachtet werden. Ein schneller Error bleibt trotzdem ein Error.
2. Traffic: Die Last, die dein System gerade bewältigen muss. Bei Web-Services wird sie meist als Anzahl der HTTP-Requests pro Sekunde gemessen.
3. Errors: Die Rate fehlgeschlagener Requests. Dazu zählen explizite Errors (HTTP 500), implizite Errors (falsche Inhalte werden ausgeliefert) oder Verstöße gegen definierte SLOs, etwa wenn vereinbarte Latenz-Werte überschritten werden.
4. Saturation: Wie stark dein Service ausgelastet ist. Gemessen werden die Ressourcen, die zuerst an ihre Grenzen kommen, wie CPU, Arbeitsspeicher oder Datenbankverbindungen.
Überwachst du diese vier Dimensionen konsequent, hast du den Zustand deines Services bereits sehr gut im Blick. Dein Error Budget schrumpft immer dann, wenn eines dieser Signale die vereinbarten Grenzwerte überschreitet.
Die Balance der Governance
In vielen Unternehmen herrscht ein ständiges Tauziehen zwischen der „Feature Factory" (Product) und den „Stability Guardians" (Operations/SRE). Das Product-Team möchte neue Features möglichst schnell ausliefern. Das Operations- oder SRE-Team muss dafür sorgen, dass die Plattform stabil bleibt. Viele Organisationen scheitern daran, weil sie diesen Zielkonflikt wie ein Nullsummen-Spiel behandeln.
Ohne ein definiertes Error Budget bleibt am Ende nur eine Diskussion auf Basis von Bauchgefühl.
"Wir haben das Gefühl, das System wird instabil!"
sagt das SRE-Team.
"Wir haben das Gefühl, wir liefern zu langsam aus!"
sagt das Product-Team.
Meist setzt sich die Produktseite durch. Neue Features lassen sich deutlich leichter mit Umsatz oder Wachstum begründen, während sich der wirtschaftliche Wert von Reliability kurzfristig nur schwer beziffern lässt.
Deshalb sollten Entscheidungen auf messbarer Reliability statt auf Bauchgefühl basieren.
Wie Error Budgets Balance bringen
Mit einem Error Budget verändert sich diese Dynamik grundlegend. Aus einer Meinungsdiskussion wird ein Governance-Mechanismus, der beiden Seiten eine gemeinsame Sprache und Entscheidungsgrundlage gibt.
Innovation (Velocity):
Solange dein Error Budget gesund ist, sollte das auch Team liefern. Experimentiert, bringt neue Features live und geht bewusst kalkulierte Risiken ein. Das Budget schafft den nötigen Spielraum dafür. Wenn nie etwas schief läuft, sind die SLOs möglicherweise zu großzügig gewählt oder es wird schlicht zu wenig Risiko eingegangen.
Reliability (Stability):
Wird das Error Budget zu schnell aufgebraucht, ist das ein klares Signal zum Innehalten. Statt neue Features auszuliefern, sollte der Fokus darauf liegen, die technische Basis zu verbessern. Jetzt ist die Zeit, Technical Debt abzubauen, Pipelines zu optimieren und endlich die flakey Tests zu beheben.
IT wie eine Steckdose zu behandeln, aus der jederzeit zuverlässig Strom kommt, klingt bequem, blendet aber aus, was alles dafür nötig ist. Ein Error Budget zwingt dazu, sich nicht nur mit dem Ergebnis zu befassen, sondern auch mit dem Weg dorthin.
Die Ausnahme
Irgendwann wirst du gegen eine Wand fahren: Ein kritischer Launch steht bevor, aber dein Error Budget ist bereits vollständig aufgebraucht. Genau in solchen Situationen schlägt Pragmatismus den Dogmatismus.
Jedes robuste Error Budget braucht eine Ausnahme für genau solche Fälle. Wer ein Release trotz ausgeschöpftem Budget freigibt, verpflichtet sich im nächsten Sprint zu Reliability Work. Es ist ein Kredit, kein Geschenk.
Nicht jeder Failure ist gleich
Hier wird es nochmal interessant: Die Abbildung unten zeigt zwei unterschiedliche Arten, wie ein Error Budget verbrannt werden kann:
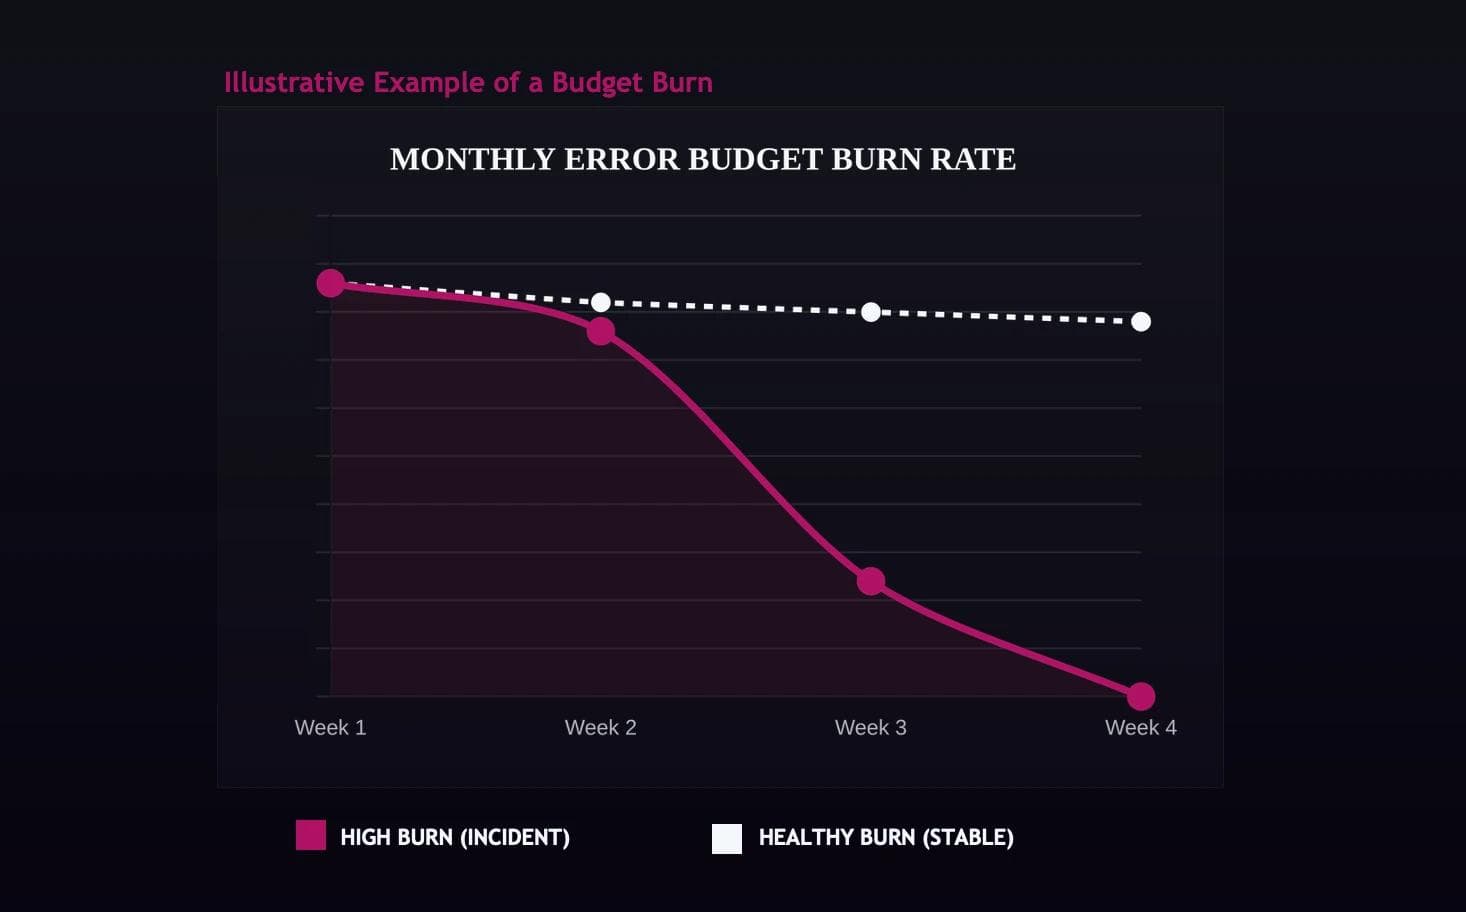
Diagram illustrating an example of a Budget Burn
Auf der einen Seite ist der Healthy Burn (Stable):
Das Budget wird langsam und kontrolliert verbraucht, wie es sich gehört. Es repräsentiert die Cost of Doing Business: kleinere Probleme bei Deployments, kurzfristige Netzwerkausfälle oder der gelegentliche kleine Bug. Eine perfekt flache Burn-Kurve wäre sogar ein Warnsignal. Entweder investierst du zu viel in Reliability oder du bringst nicht genug Veränderungen in die Produktion.
Auf der anderen Seite steht der High Burn (Incident).
Schau dir an, was um Woche 2 im Chart passiert. Das Budget wird innerhalb kürzester Zeit aufgebraucht. Spätestens in Woche 4 ist es leer. Das ist ein deutliches Signal dafür, dass dein System nicht mehr die Reliability liefert, für die es ausgelegt wurde.
Diese Burn Rate zu beobachten ist viel wichtiger, als nur auf das verbleibende Budget zu schauen. Selbst wenn erst 10 % davon verbraucht sind, kann eine Burn Rate, die hundertmal höher ist als normal, bereits auf einen akuten Incident hindeuten.
Genau deshalb warten High-Performing-Teams nicht bis das Budget vollständig aufgebraucht ist. Stattdessen nutzen sie Burn Rate Alerting, um kritische Probleme frühzeitig zu erkennen.
The Point of No Return
Was passiert, wenn die pinke Linie im Chart die Null erreicht? Genau dann zeigt sich, ob SRE in deinem Unternehmen wirklich gelebt wird. Passiert nach Erreichen des Error Budgets nichts, ist diese kein Governance-Tool, sondern reine Dekoration.
Jetzt geht es nicht um Schuldzuweisungen, sondern um klare Regeln. Eine vorab definierte Error Budget Policy sollte automatisch greifen.
Typische Maßnahmen sind:
- Freeze Releases: Neue Features werden vorübergehend nicht mehr ausgerollt. Alle nicht kritischen Deployments werden eingefroren. Der Fokus liegt jetzt vollständig auf Reliability. Erlaubt sind nur noch P0-/P1-Incidents, Security Fixes oder Maßnahmen, die unmittelbar zur Wiederherstellung des vereinbarten SLOs beitragen.
- Der "Reliability Surcharge": Das Engineering-Team konzentriert sich vorübergehend vollständig auf Reliability. Dazu gehören beispielsweise das Refactoring von fragilem Code, der Ausbau von Observability oder der Abbau von Technical Debt. Ziel ist es, das Gleichgewicht zwischen Innovation und Stabilität wiederherzustellen.
- Post-Mortems mit konkreten Maßnahmen: Verbraucht ein einzelner Incident einen erheblichen Teil des Error Budgets (etwa mehr als 20 %), wird ein Post-Mortem verpflichtend. Noch wichtiger sind jedoch die daraus abgeleiteten Maßnahmen: Sie haben im darauffolgenden Sprint Vorrang vor jeglichen neuen Features.
Die Gefahr unrealistischer SLOs
Versucht man das System auszutricksen, indem SLOs bewusst zu niedrig angesetzt werden, tappt man schnell in eine Falle. Ein SLO von 95 % mag auf dem Papier toll aussehen. Wenn deine Nutzer 99,9 % erwarten, läuft dein Error Budget nie leer – deine Kunden dafür schon.
Ein Error Budget ist deshalb immer nur so gut wie die Service Level Objectives, auf denen es basiert. Sie müssen sich an den Erwartungen der Nutzer orientieren, nicht daran, was sich möglichst leicht erreichen lässt.
Dashboard showing 100% reliability while customer complaints flood the office.
Fazit: Reliability ist Teamarbeit
Error Budgets sind ein leistungsfähiges Werkzeug. Doch genau wie ein Hochleistungs-Bremssystem entfalten sie ihren Wert erst dann, wenn du bereit bist, im entscheidenden Moment auch auf die Bremse zu treten.
Ein Error Budget einzuführen bedeutet deshalb weit mehr, als nur ein Dashboard in Prometheus aufzusetzen. Es erfordert einen Kulturwandel.
Das Ziel ist nicht Perfektion zu erreichen, sondern Innovation zu beschleunigen, ohne die Reliability aus den Augen zu verlieren.
Der eigentliche Wandel besteht darin, reaktives Feuerlöschen gegen robuste Prozesse, klare Leitplanken und datenbasierte Entscheidungen zu tauschen.
Wenn also das nächste Mal jemand 100% Uptime fordert, zeig ihm einfach das Burndown-Chart. Es ist deutlich günstiger (und ehrlicher), den Burn bewusst einzuplanen, als so zu tun, als ließe er sich vermeiden.